kafka的HA设计
选举算法
replica(消息的副本)设计是partition最重要的概念,副本机制是很多分布式数据系统实现高可用的常用方法。看一下下partition和replica的关系。
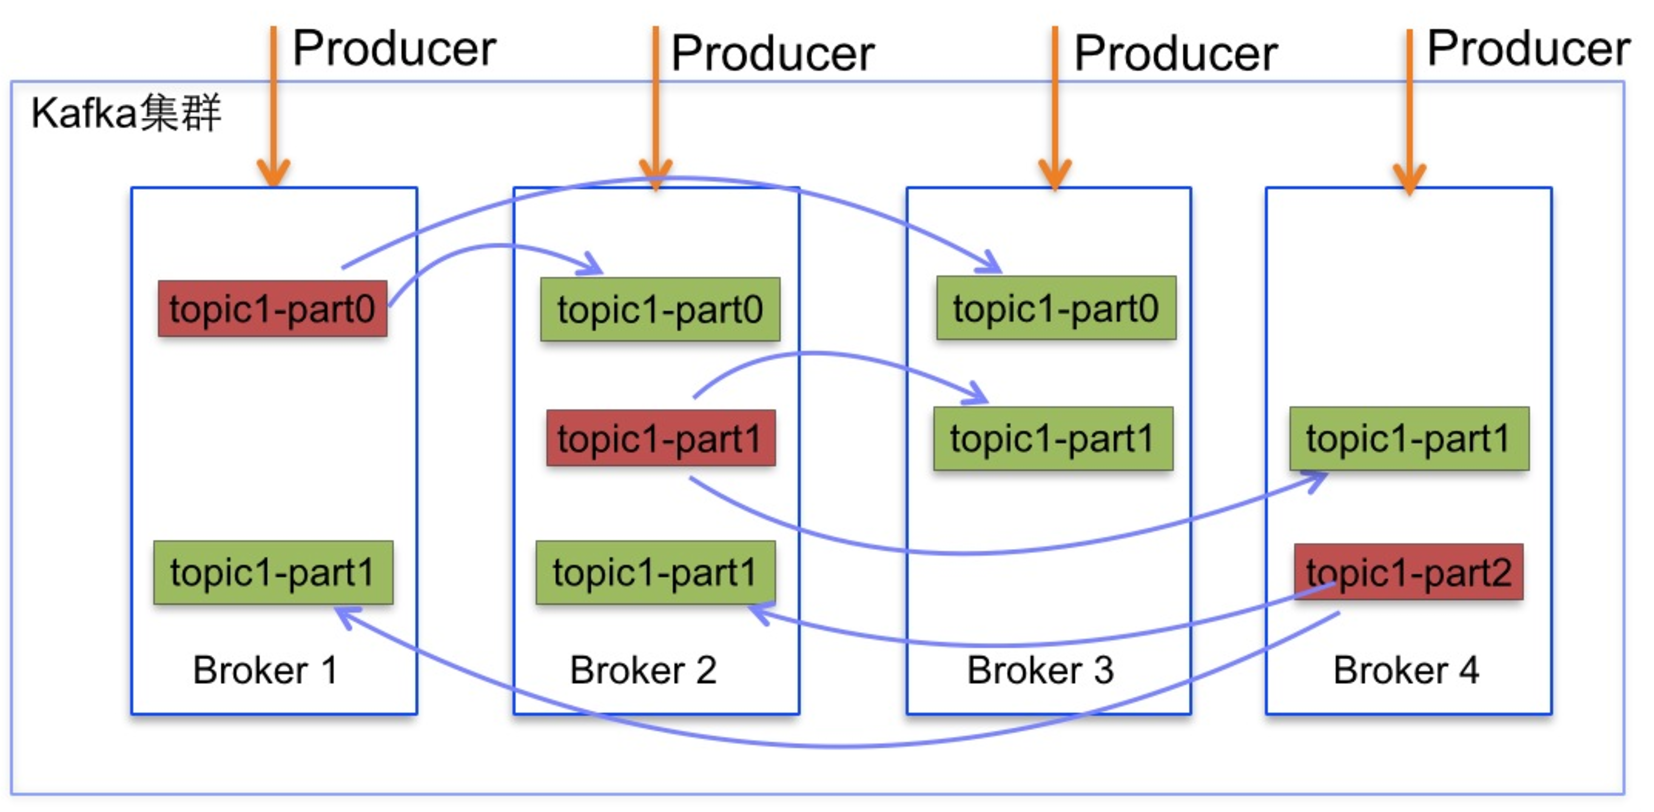
<blockquote> <p>partition和replica默认分配到哪个broker的策略是:</p> <p>将所有N Broker和待分配的i个Partition排序.</p> <p>将第i个Partition分配到第(i mod n)个Broker上.</p> <p>将第i个Partition的第j个副本分配到第((i + j) mod n)个Broker上.</p> </blockquote> 客户端生产消费消息都是只跟leader交互,这一点设计跟有些分布式系统有所不用(比如zk设计写操作只能在leader交互,读操作可以是leader也可以是follower)。个人认为主要还是考虑到实现上简单。 leader是对应partition的概念,每个partition都有一个leader。
ISR
zookeeper的 <a href="https://link.jianshu.com?t=http://web.stanford.edu/class/cs347/reading/zab.pdf" target="_blank" rel="nofollow">Zab</a> 协议算法是这个Majority Vote的类型,raft也是。而Kafka所使用的这种ISR概念的算法更像微软的 <a href="https://link.jianshu.com?t=http://research.microsoft.com/apps/pubs/default.aspx?id=66814" target="_blank" rel="nofollow">PacificA</a> 算法。
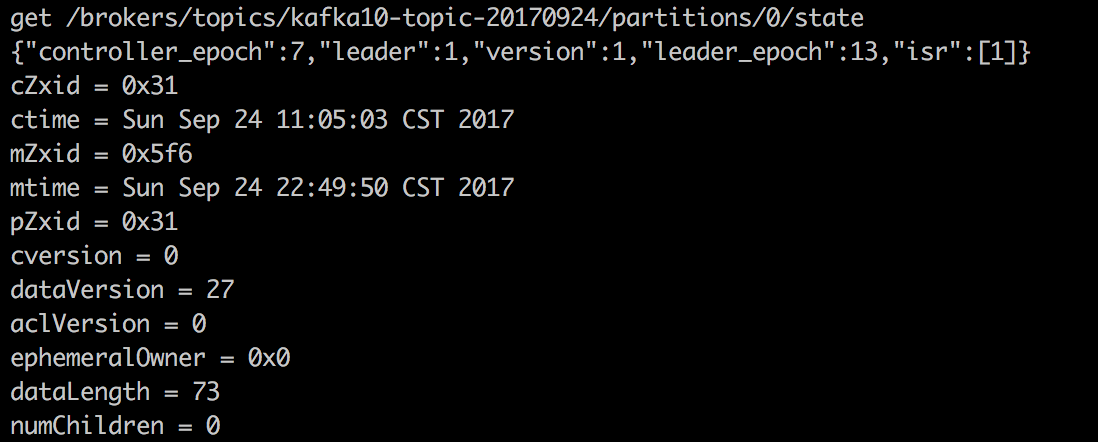
<blockquote> <p><b>ISR(In-Sync Replicas)直译就是跟上leader的副本<br></b></p> </blockquote> 是怎样使用ISR概念,在Follower中选举出新的Leader昵? <blockquote> <p><b>选leader一个基本的原则就是</b>,如果Leader不在了,新的Leader必须拥有原来的Leader commit过的所有消息。ISR列表里的副本都跟上了leader,所以就是在这里边选一个。</p> </blockquote>
那如何维护这个ISR列表就是算法要实现的核心内容?
producer写数据到leader,那副本是如何同步数据的昵?副本(replica)有单独的fetch线程去拉取同步消息。拉取的时间间隔可配置。
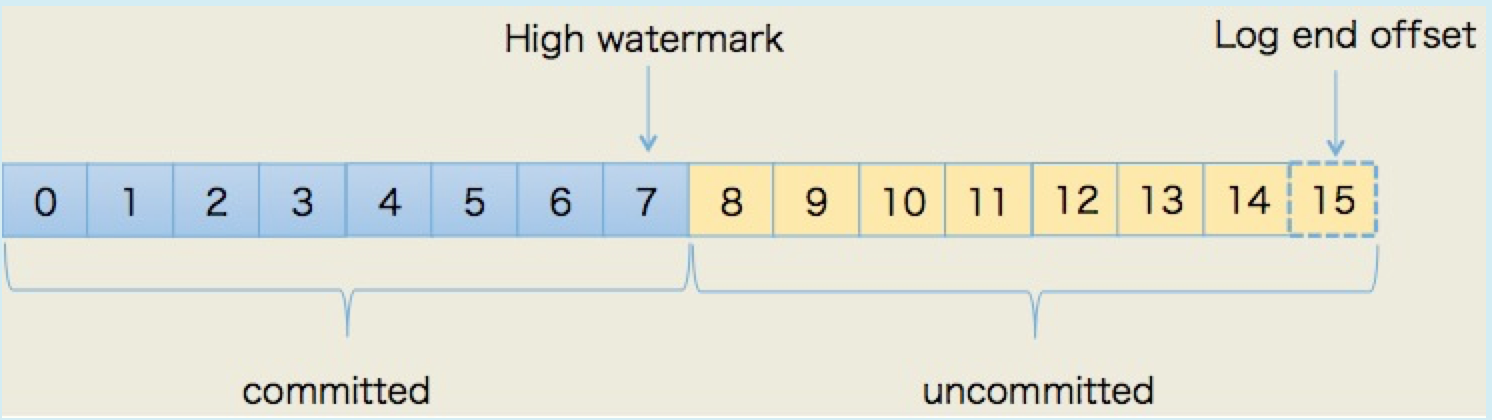
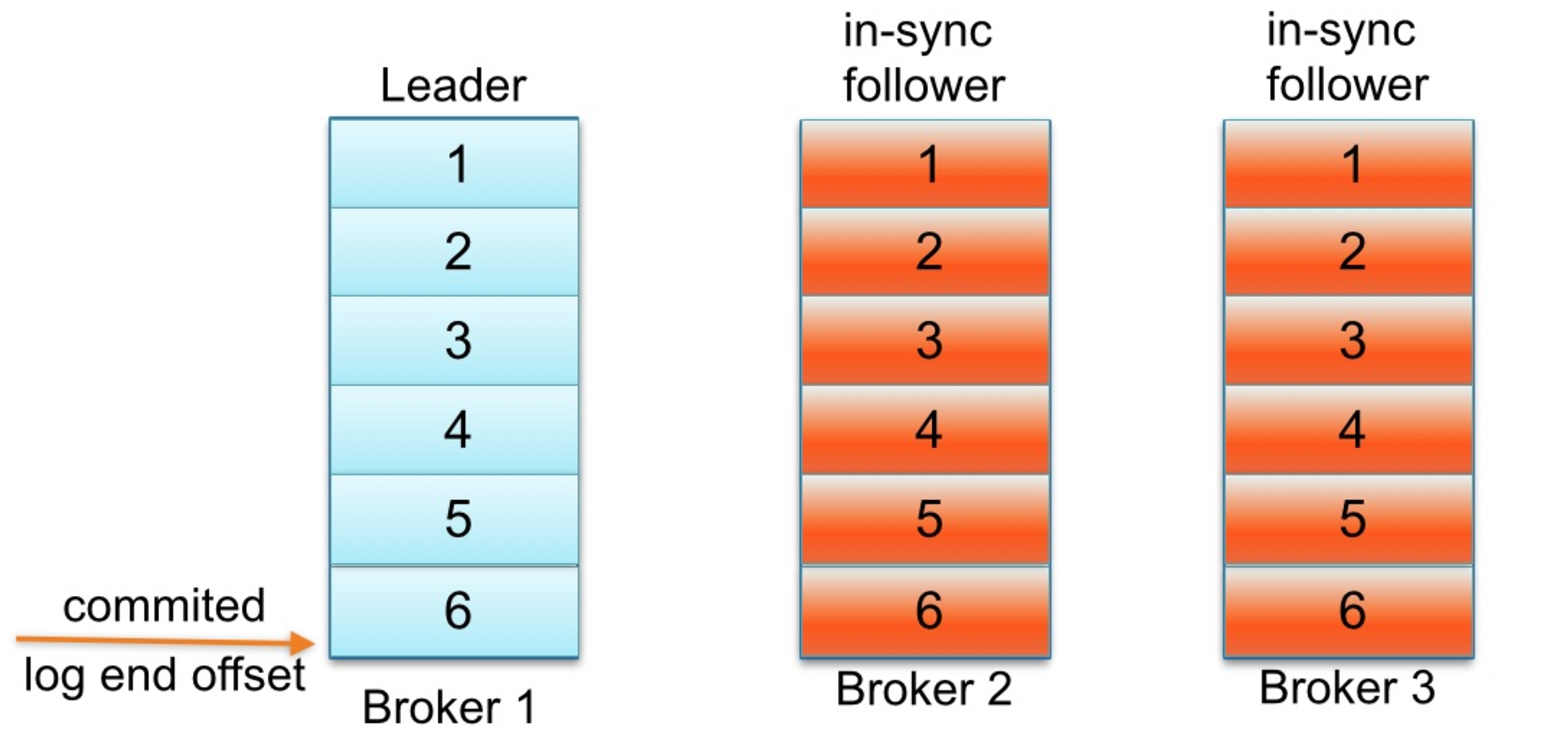
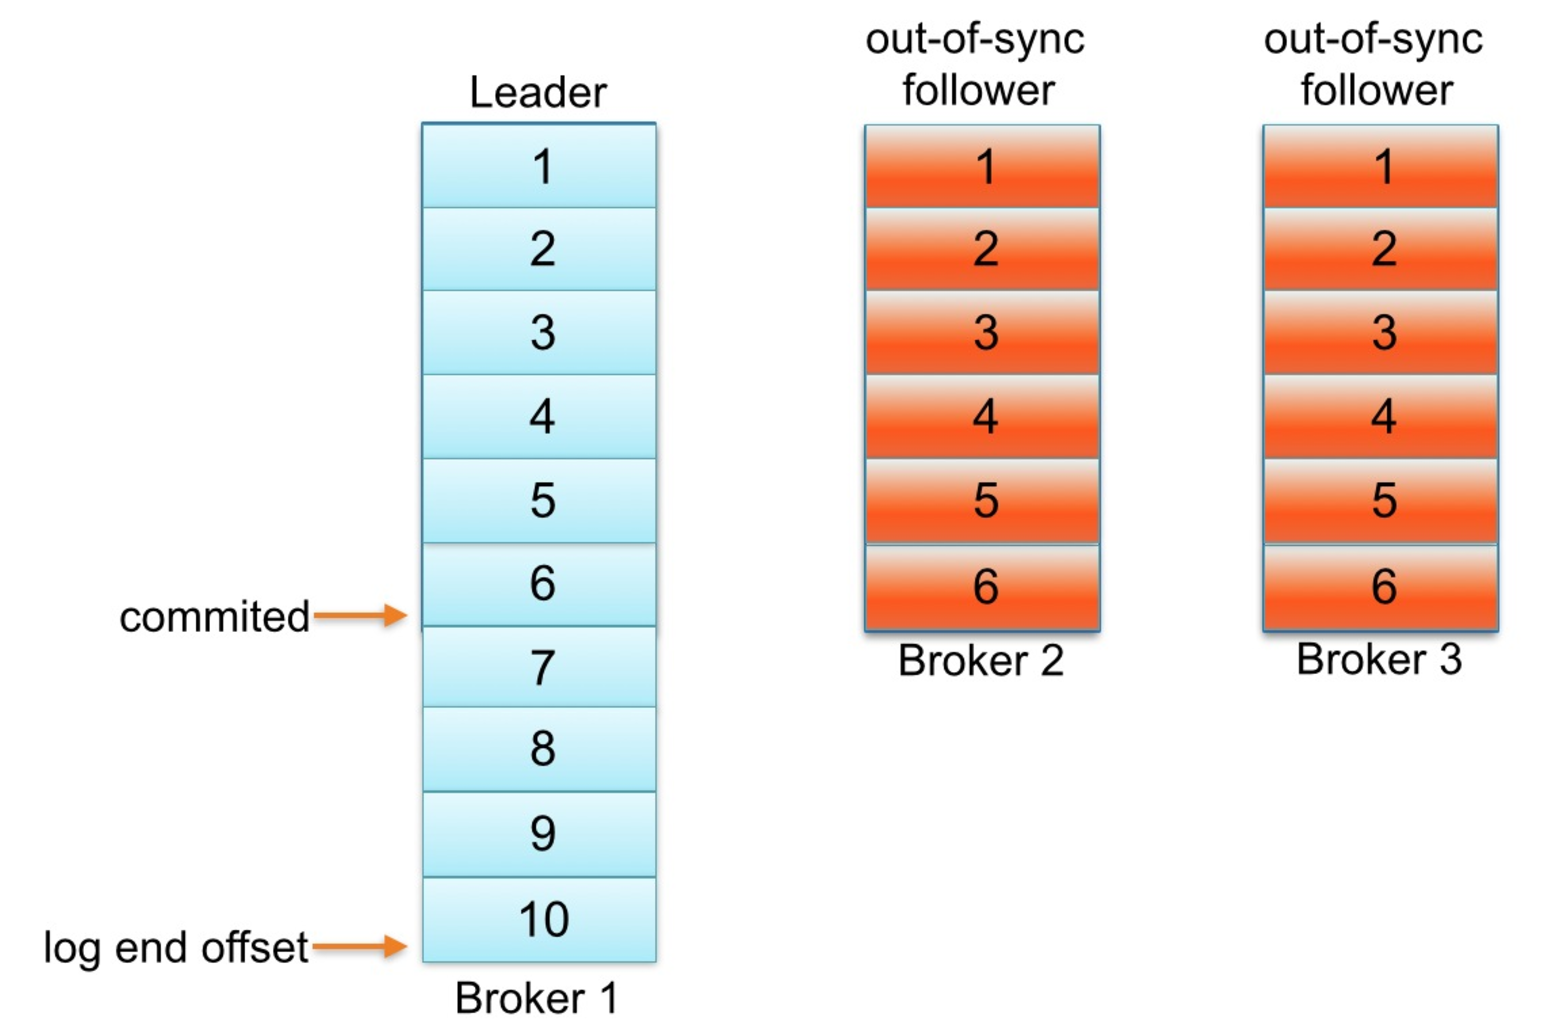
<blockquote> <p>High watermark(高水位线)以下简称HW,表示消息被leader和<b>ISR</b>内的follow都确认commit写入本地log,所以在HW位置以下的消息都可以被消费(不会丢失)。</p> <p>Log end offset(日志结束位置)以下简称LEO,表示消息的最后位置。LEO>=HW,一般会有没提交的部分。</p> </blockquote> ISR概念的引入就在这里。 副本会有单独的线程(ReplicaFetcherThread),去从leader上去拉去消息同步。当follower的HW赶上leader的,就会保持或加入到ISR列表里,就说明此follower满足上述最基本的原则(跟上leader进度)。ISR列表存在zookeeper上。
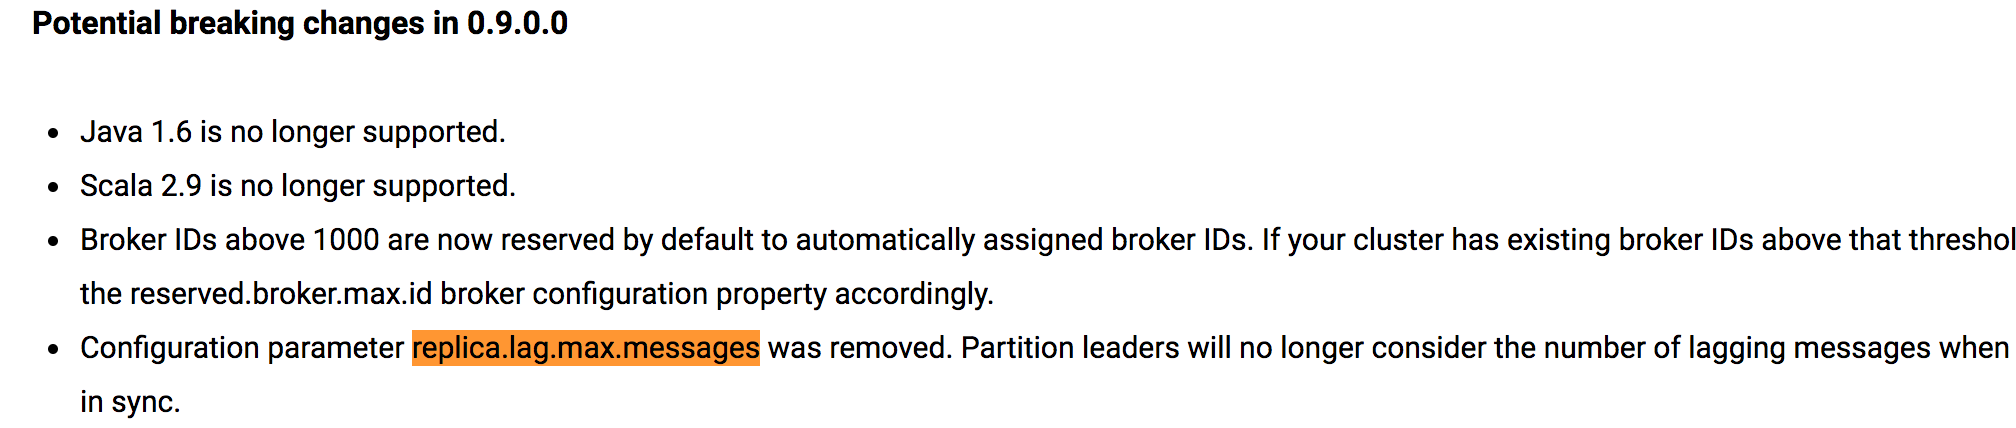
那如何确定follower赶上leader进度昵?有两参数决定是否"赶上" <blockquote> <p><b>replica.lag.max.messages 落后的消息个数<br></b></p> <p><b>replica.lag.time.max.ms 多长时间没有发送FetchQuest请求拉去leader数据<br></b></p> </blockquote> 比如落后消息达到设置的100,10s中没有再发送FetchRequest请求,就会从ISR列表中移除。有了两个参数概念,可应该能理解,replica.fetch.wait.max.ms(默认10s)这个参数是发送fetchRequest频率(最大等待时间),这个值要始终小于replica.lag.time.max.ms(默认500ms),以保证replica不会被频繁的移除ISR <br> 参数官方解释见 <a href="https://link.jianshu.com?t=http://kafka.apache.org/documentation/" target="_blank" rel="nofollow">http://kafka.apache.org/documentation/</a> kafka新版本对这两个参数做了优化,移除了落后消息个数参数(replica.lag.max.messages),原因是这个值不好把控,需要经验值,不用的业务服务器环境,这个值可能不同,不然会频繁的移除加入ISR列表。细节分析推荐参考 <a href="https://link.jianshu.com?t=http://www.cnblogs.com/huxi2b/p/5903354.html" target="_blank" rel="nofollow">博文</a>
举个🌰,正常运行时,如下图
当follow可能的IO耗时过高,经历了一次full gc耗时很多时,达到了上述两个条件,follow被移除了ISR列表。此时的HW还是6,leader上的LEO是10。消费者只能消费offset到6。
设计好如何维护一个ISR列表,就完成这个算法主要的工作。完成上述过程,维护了一个ISR列表,就能保证leader不可用时,可以从ISR中选一个replica作为leader继续工作。
<br>
cap理论,在分布式系统下,要在a高可用性和c一致可靠性做个折衷
<blockquote> <p>知道上述设计,而为了让ISR能一直有replica,保证正常的HA,这就需要作一个折衷。</p> </blockquote>
如果Leader在一条消息被commit前等待更多的Follower确认,那在它宕机之后就有更多的Follower可以作为新的Leader,但这也会造成吞吐率的下降。
所以有了producer的ack参数选择,取优先考虑可靠性,还是优先考虑高并发。以下不用的参数,会导致有可能丢消息。
<blockquote> <p>0表示纯异步,不等待,写进socket buffer就继续。</p> <p>1表示leader写进server的本地log,就返回,不等待follower的回应。</p> <p>-1相当于all,表示等待follower回应再继续发消息。保证了ISR列表里至少有一个replica,数据就不会丢失,最高的保证级别。</p> </blockquote>
跟Majority Vote算法的比较理解
常见的leader的选举算法还有Majority Vote(少数服从多数),但Kafka并未采用这种方式。比较一下两种算法:
<blockquote> <p>Majority Vote:如果我们有2f+1个Replica(包含Leader和Follower),那在commit之前必须保证有f+1个Replica复制完消息,为了保证正确选出新的Leader,fail的Replica不能超过f个。因为在剩下的任意f+1个Replica里,至少有一个Replica包含有最新的所有消息。</p> <p>优点是,系统的潜力只取决于<b>最快的几个Broker,而非最慢那个</b>。</p> <p>劣势是,<b>同等数量</b>的机器,它所能容忍的fail的follower<b>个数比较少</b>。比如:如果要容忍1个follower挂掉,必须要有3个以上的Replica,如果要容忍2个Follower挂掉,必须要有5个以上的Replica。</p> <p>结论是:就是这种算法更多用在<a href="#" target="_blank" rel="nofollow">Zookeeper</a>这种共享集群配置的系统中使用,而很少在需要存储大量数据的系统中使用的原因。</p> </blockquote>
<blockquote> <p>Kafka在Zookeeper中动态维护了一个ISR(in-sync replicas),这个ISR里的所有Replica都跟上了leader,只有ISR里的成员才有被选为Leader的可能。</p> <p>优点:在这种模式下,对于f+1个Replica,一个Partition能在保证不丢失已经commit的消息的前提下容忍f个Replica的失败。</p> <p>缺点:相应的,leader需要等待最慢的那个replica,但是Kafka作者认为Kafka可以通过Producer选择是否被commit阻塞来改善这一问题,trade-off就是节省下来的Replica和磁盘。</p> </blockquote>
<br>
<br> ISR至少有一个replica,能保证不丢消息,如果ISR里的副本都被移除了怎么处理呢? 有两种方式,这就需要在可用性与一致性做个妥协。
<blockquote> <p>等待ISR中的任一个Replica“活”过来,并且选它作为Leader</p> <p>选择第一个“活”过来的Replica(不一定是ISR中的)作为Leader</p> </blockquote>
选择第一种方式,有可能要等很长时间;选第二种方式会丢消息,但是能很快响应。

<blockquote> <p>服务端提供参数<b>unclean.leader.election.enable</b>选择上述方式</p> <p>默认是true,表示允许不在ISR列表的follower,选举为leader(最坏的打算,可能丢消息)</p> </blockquote>
读者留言
COMMENTS 暂无还没有留言,来说第一句?